16:06
Tufa Labs-in AI sistemi 1 GB mətni itkisiz 105,39 MB-a sıxıb
“Tufa Labs” 19 noyabr 2026-cı ildə “tufazip” adlı yeni sıxılma təcrübəsinin nəticələrini açıqlayıb. Sistem “Wikipedia”dan götürülmüş 1 GB mətni heç bir məlumat itirmədən 105,39 MB-a qədər kiçildib. Bu, mətni yalnız neyron şəbəkəsinin proqnozları ilə sıxan həllər arasında “Large Text Compression Benchmark” sınağının ən yaxşı nəticəsidir. Ancaq “tufazip” hələ gündəlik istifadə üçün hazır məhsul deyil.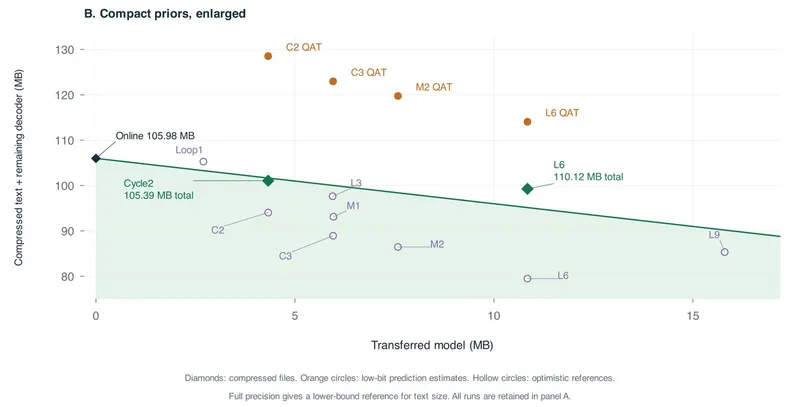 “tufazip” mətnin davamını təxmin edən 163 milyon parametrli Transformer modeli ilə işləyir. Tam modeldə 12 qat var, yəni hər proqnoz 12 mərhələdən keçir. Arxivə əlavə olunan ilkin model 34 milyon parametrdən ibarətdir və cəmi 4,33 MB yer tutur. Onun əvvəlcədən öyrədilmiş 2 qatı yaddaşda kopyalanaraq 12 qata çatdırılır. Mətn emal olunduqca hər nüsxə ayrıca öyrənir. Sistem adi çatbot və ya bulud xidməti deyil. O, mətn üzərində işlədikcə özünü öyrədən müstəqil dil modelidir. Sıxılma zamanı model hər tokeni, yəni mətnin kiçik bir hissəsini proqnozlaşdırır və nəticədən öyrənir. Fayl açılarkən eyni addımlar yenidən təkrarlanır. Buna görə prosesin hər dəfə eyni nəticəni verməsi vacibdir. Faylda tam öyrədilmiş model saxlanmır. Arxivdə yalnız sıxılmış mətn, onu açan proqram və ilkin model var. 19 noyabr yeniləməsində bu versiya ümumi cədvələ daxil olub. 105,39 MB-lıq nəticə siyahıda 13-cü yeri tutub. Daha yuxarıdakı 12 həll Transformer-lə yanaşı, mütəxəssislərin hazırladığı ənənəvi sıxılma üsullarından da yararlanır. Sentyabrın əvvəlində çıxan ilk versiya isə bütün öyrənmə prosesini işlədiyi vaxt aparırdı və ən yaxşı 2 nəticə arasına düşmüşdü. Sınaq yalnız mətn faylları üçündür; foto, video və digər media formatları bu yoxlamaya daxil deyil. Belə nəticə əldə etmək üçün xeyli vaxt və güclü avadanlıq lazımdır. Sınaqda 2 “Nvidia B200” qrafik prosessoru və 2 “Intel Xeon Platinum 8570” prosessoru işlədilib. Bu avadanlıqla sıxılma 631 548 saniyə, yəni təxminən 7,3 gün çəkib. Faylın açılması 645 748 saniyə və ya təxminən 7,5 gün davam edib. Qrafik yaddaş sərfi ən çox 43,37 GiB olub. Ümumi yaddaş istifadəsi sıxılma zamanı 68 525 MiB, açılma zamanı 73 748 MiB-ə çatıb. Təcrübə daha böyük modelin həmişə daha yaxşı işləmədiyini də göstərib. 4 min vahidlik token lüğəti 8 min vahidlik variantdan daha səmərəli olub. O, 16 min vahidlik lüğəti də geridə qoyub. “Wikipedia” mətnindəki XML işarələri üçün ayrıca tokenlər yaratmaq isə nəticəni pisləşdirib. 267 milyon parametrli model 188 milyon parametrli modeldən bir qədər zəif işləyib. Öyrənmə zamanı nəzərə alınan əvvəlki mətnin həcmi 15 milyon tokendən 35 milyona qaldırılıb. Nəticədə fayl cəmi 1,21% kiçilib, hesablama yükü isə 40% artıb.